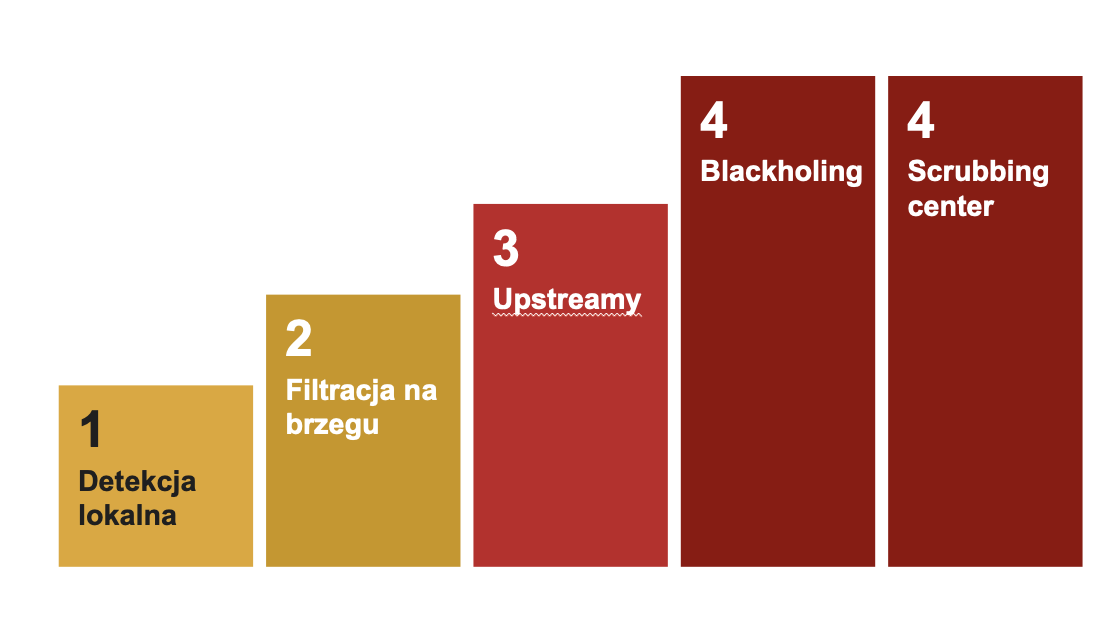
System antyDDoS w sieci operatora to nie jedno narzędzie, tylko kolejne szczeble ochrony: od widoczności ruchu we własnej sieci, przez filtrację na routerze brzegowym, po współpracę z upstreamami. Opisujemy je w kolejności, w jakiej warto je budować, na przykładzie systemu LiveShield. Każdy szczebel odpowiada na inny problem i wymaga od operatora innej decyzji.
Czym jest drabina eskalacyjna w ochronie antyDDoS?
Drabina eskalacyjna to kolejność reakcji na atak: zaczynamy od tego, co operator kontroluje lokalnie, a zasoby zewnętrzne włączamy dopiero na wyższych szczeblach. Wyższe szczeble opierają się na niższych, więc budowanie ich od góry nie ma sensu.
Operator powinien wiedzieć lokalnie, co uderza w jego sieć. Upstream nie widzi wszystkiego, zwłaszcza gdy sieć ma kilka styków. Zewnętrzne scrubbing center też potrzebuje lokalnej detekcji, raportowania i przekierowania, żeby w ogóle zadziałać.
Krok 1: Dlaczego system antyDDoS zaczyna się od widoczności ruchu?
Bez szybkiej detekcji nie da się filtrować ani raportować ataku, więc widoczność ruchu jest pierwszym i najważniejszym szczeblem. Operator musi widzieć, co uderza w jego sieć, i to w czasie liczonym w sekundach. Operatorzy podlegający KSC muszą ponadto obsługiwać i zgłaszać incydenty, a żeby to zrobić, trzeba je najpierw wykryć i udokumentować.
Dlatego LiveShield nie opiera detekcji na NetFlow. NetFlow jest zbyt wolny, a do analizy nie trafia cały ruch. System analizuje kopię ruchu z lustra: z portu SPAN na routerze lub przełączniku albo z optycznego TAP-a na łączu. W teście reakcja systemu na atak trwała poniżej sekundy.
Czy analiza ruchu wymaga drogiego sprzętu?
Nie. Przetwarzanie pakietów w oparciu o DPDK omija jądro systemu, dlatego 40G ruchu obsłuży jeden serwer klasy Dell R430 z procesorem Xeon E5 v4, w cenie około 2000 zł. Jeszcze niedawno taka wydajność wymagała wielokrotnie droższego sprzętu.
Krok 2: Czy router brzegowy ogranicza ochronę przed DDoS?
Tak. Słaby router brzegowy powoduje problemy podczas ataków, bo to na nim lądują reguły filtrujące. Obsługa BGP FlowSpec jest tu wymaganiem podstawowym, ponieważ FlowSpec jest głównym mechanizmem, którym system przekazuje reguły do routera.
Router sprzętowy z układem ASIC przetwarza ruch szybko, ma pamięć TCAM i duży zapas przepustowości. Router na Linuksie jest ostatecznością i ma sens tylko z VPP lub DPDK, bo jądro systemu jest dla takiego ruchu zbyt wolne. Taki router wydaje się tani, ale wymaga czasochłonnego strojenia i nie daje gwarancji wydajności.
Mikrotik przyjmuje reguły FlowSpec, ale ich nie stosuje, więc przy takim urządzeniu zostaje blackholing.
Krok 3: Jak filtrować atak bez odcinania legalnego ruchu?
Skuteczna filtracja łączy dwa mechanizmy: prefiltering i advanced filtering. Efektem obu są reguły BGP FlowSpec wysyłane na router, więc legalny ruch do atakowanego adresu płynie dalej.
Prefiltering to predefiniowane reguły dla najczęstszych wektorów ataku, np. NTP, DNS czy ICMP. Działają od razu, bez czekania na uczenie ruchu.
Advanced filtering to dynamiczne uczenie ruchu na podstawie zawartości pakietów. Jest niezbędny przy atakach z botnetów i przy ruchu takim jak TCP czy UDP, którego nie można po prostu wyciąć.
Blackholing selektywny jest ostatnim szczeblem, nie pierwszym. Ma sens głównie dla pojedynczych adresów. Nie sprawdza się przy długich atakach carpet bombing, a nie każdy upstream przyjmuje prefiksy szersze niż /32. Nie odcinamy ruchu lokalnie: ruch z IXP i peeringów bezpośrednich zostaje.
Przy ataku rozproszonym na całą podsieć (carpet bombing) liczą się progi per podsieć, a nie tylko per adres IP. Bez progów per podsieć taki atak nie zostanie wykryty.
Krok 4: Co sprawdzić u upstreamów przed atakiem?
Lokalna filtracja nie wystarczy, jeśli atak wysyca łącze, zanim ruch dotrze do routera brzegowego. Dlatego dobór upstreamów jest decyzją zakupową, którą warto domknąć przed pierwszym dużym atakiem.
Na co zwrócić uwagę:
Przepustowość portów. Porty 10G są dziś często za małe. Tam, gdzie to możliwe, warto przejść na porty o wyższej przepustowości z niższym commitmentem.
Sterowanie ruchem. Łącza typu mix utrudniają sterowanie ruchem, bo nie wiadomo, skąd i ile ruchu przychodzi.
FlowSpec u upstreamu. Upstream bez FlowSpec to problem przy każdym większym ataku, zwłaszcza typu carpet bombing. Upstream, który udostępnia FlowSpec lub RTBH, pozwala wysyłać reguły i prefiksy bezpośrednio do jego routerów. To trzeba potwierdzić z każdym dostawcą osobno.
Opcjonalnym uzupełnieniem jest zewnętrzne scrubbing center. LiveShield nie ma własnego scrubbing center, ale może przekierować do niego ruch, a próg przekierowania można powiązać z wysyceniem łącza. Scrubbing center uzupełnia wtedy lokalną ochronę, a jej nie zastępuje.
Krok 5: Co z atakami, które wyglądają jak legalny ruch?
Takie ataki wymagają stanowej analizy ruchu, bo pojedynczy pakiet nie zdradza, że jest częścią ataku. Typowym przykładem jest SYN-ACK reflection oraz mieszanka różnych wektorów naraz. Samymi progami per protokół nie da się ich skutecznie zatrzymać bez ryzyka odcięcia legalnych połączeń.
Do takich przypadków służy LiveShield AIF. Działa inline, między routerem brzegowym a BRAS lub koncentratorem, i dwukierunkowo śledzi stan połączeń TCP. Opiera się na DPDK, więc pracuje z dużą szybkością.
AIF nie zastępuje pojemności łączy. Atak, który wysyca łącze upstreamu, trzeba nadal obsłużyć na wyższych szczeblach: przez FlowSpec lub RTBH u upstreamów.
Krok 6: Jak dokumentować ataki i automatyzować reakcję?
Operator powinien w każdej chwili widzieć, co system robi, i móc to wykorzystać we własnych procesach. LiveShield pokazuje wszystkie reguły aktywne pod atakiem, wykresy z podziałem per upstream oraz generuje raporty, w tym raport pod KSC. Raport służy do przygotowania zgłoszenia, ale system nie wysyła go automatycznie.
Własne event pipeline pozwalają uruchamiać powiadomienia e-mail, webhooki i skrypty. Skrypt może też zmieniać konfigurację urządzeń sieciowych, na przykład przestać rozgłaszać prefiksy do wybranych upstreamów, przełączyć ruch na scrubbing center albo zostawić tylko upstream obsługujący FlowSpec.
Reguły można też tworzyć ręcznie, niezależnie od automatycznej detekcji, a konfigurację zmieniać przez publiczne API.
Krok 7: Jak radzić sobie z atakami z IXP?
Atak z IXP można ograniczyć, namierzając jego źródło zamiast odcinać cały punkt wymiany. Do namierzenia potrzebne są dobre wykresy per upstream oraz próbki ruchu.
Procedura wygląda tak:
Na wykresach per upstream widać, że ruch wchodzi przez IXP.
Z próbek ruchu odczytujemy adres MAC źródła.
Na podstawie MAC ustalamy adres IP peera i jego numer ASN.
Rozgłaszamy do wybranego ASN community do-not-announce, zależnie od zasad danego IXP.
Ruch tego peera nie wchodzi wtedy do sieci przez IXP, tylko trafia na ścieżki tranzytowe.
Co sprawdzić w swojej sieci, zanim pojawi się atak?
Najszybciej zacząć od pytań, które nie wymagają zakupów:
Czy da się skopiować ruch z brzegu sieci (SPAN lub TAP)?
Czy router brzegowy obsługuje BGP FlowSpec i które modele mamy w sieci?
Czy każdy upstream udostępnia FlowSpec lub RTBH i na jakich zasadach?
Czy znamy progi, przy których nasze łącza zaczynają być wysycone?
Kto i jak reaguje, gdy atak trafia w sieć poza godzinami pracy?
Odpowiedzi pokazują, który szczebel drabiny jest dziś najsłabszy. Dopiero wtedy warto planować wdrożenie systemu.
Omówimy to na żywo na Zjeździe MiŚOT w Nałęczowie (26-28.10.2026). Wykład "Stare zagrożenia, nowe technologie - DDoS w 2026 roku" odbędzie się we wtorek 27 października o 12:40 i poprowadzi go Mateusz Gołębiewski. Na stoisku LiveShield pomożemy ocenić, gdzie podłączyć mirror ruchu i jakie routery w Państwa sieci obsługują FlowSpec. Możecie też zobaczyć panel w wersji demo albo napisać na [email protected].