23 października 2026 r. Pełnomocnik Rządu do Spraw Cyberbezpieczeństwa wydał zaktualizowaną rekomendację dotyczącą ochrony dostawców internetu przed atakami DDoS (nr 2026/67a/5, podstawa: art. 67a ustawy o krajowym systemie cyberbezpieczeństwa). Ministerstwo Cyfryzacji opublikowało ją 26 października, a przygotowano ją we współpracy z UKE i CSIRT NASK. Dokument aktualizuje wersję z 29 czerwca 2026 r. i zawiera 15 punktów.
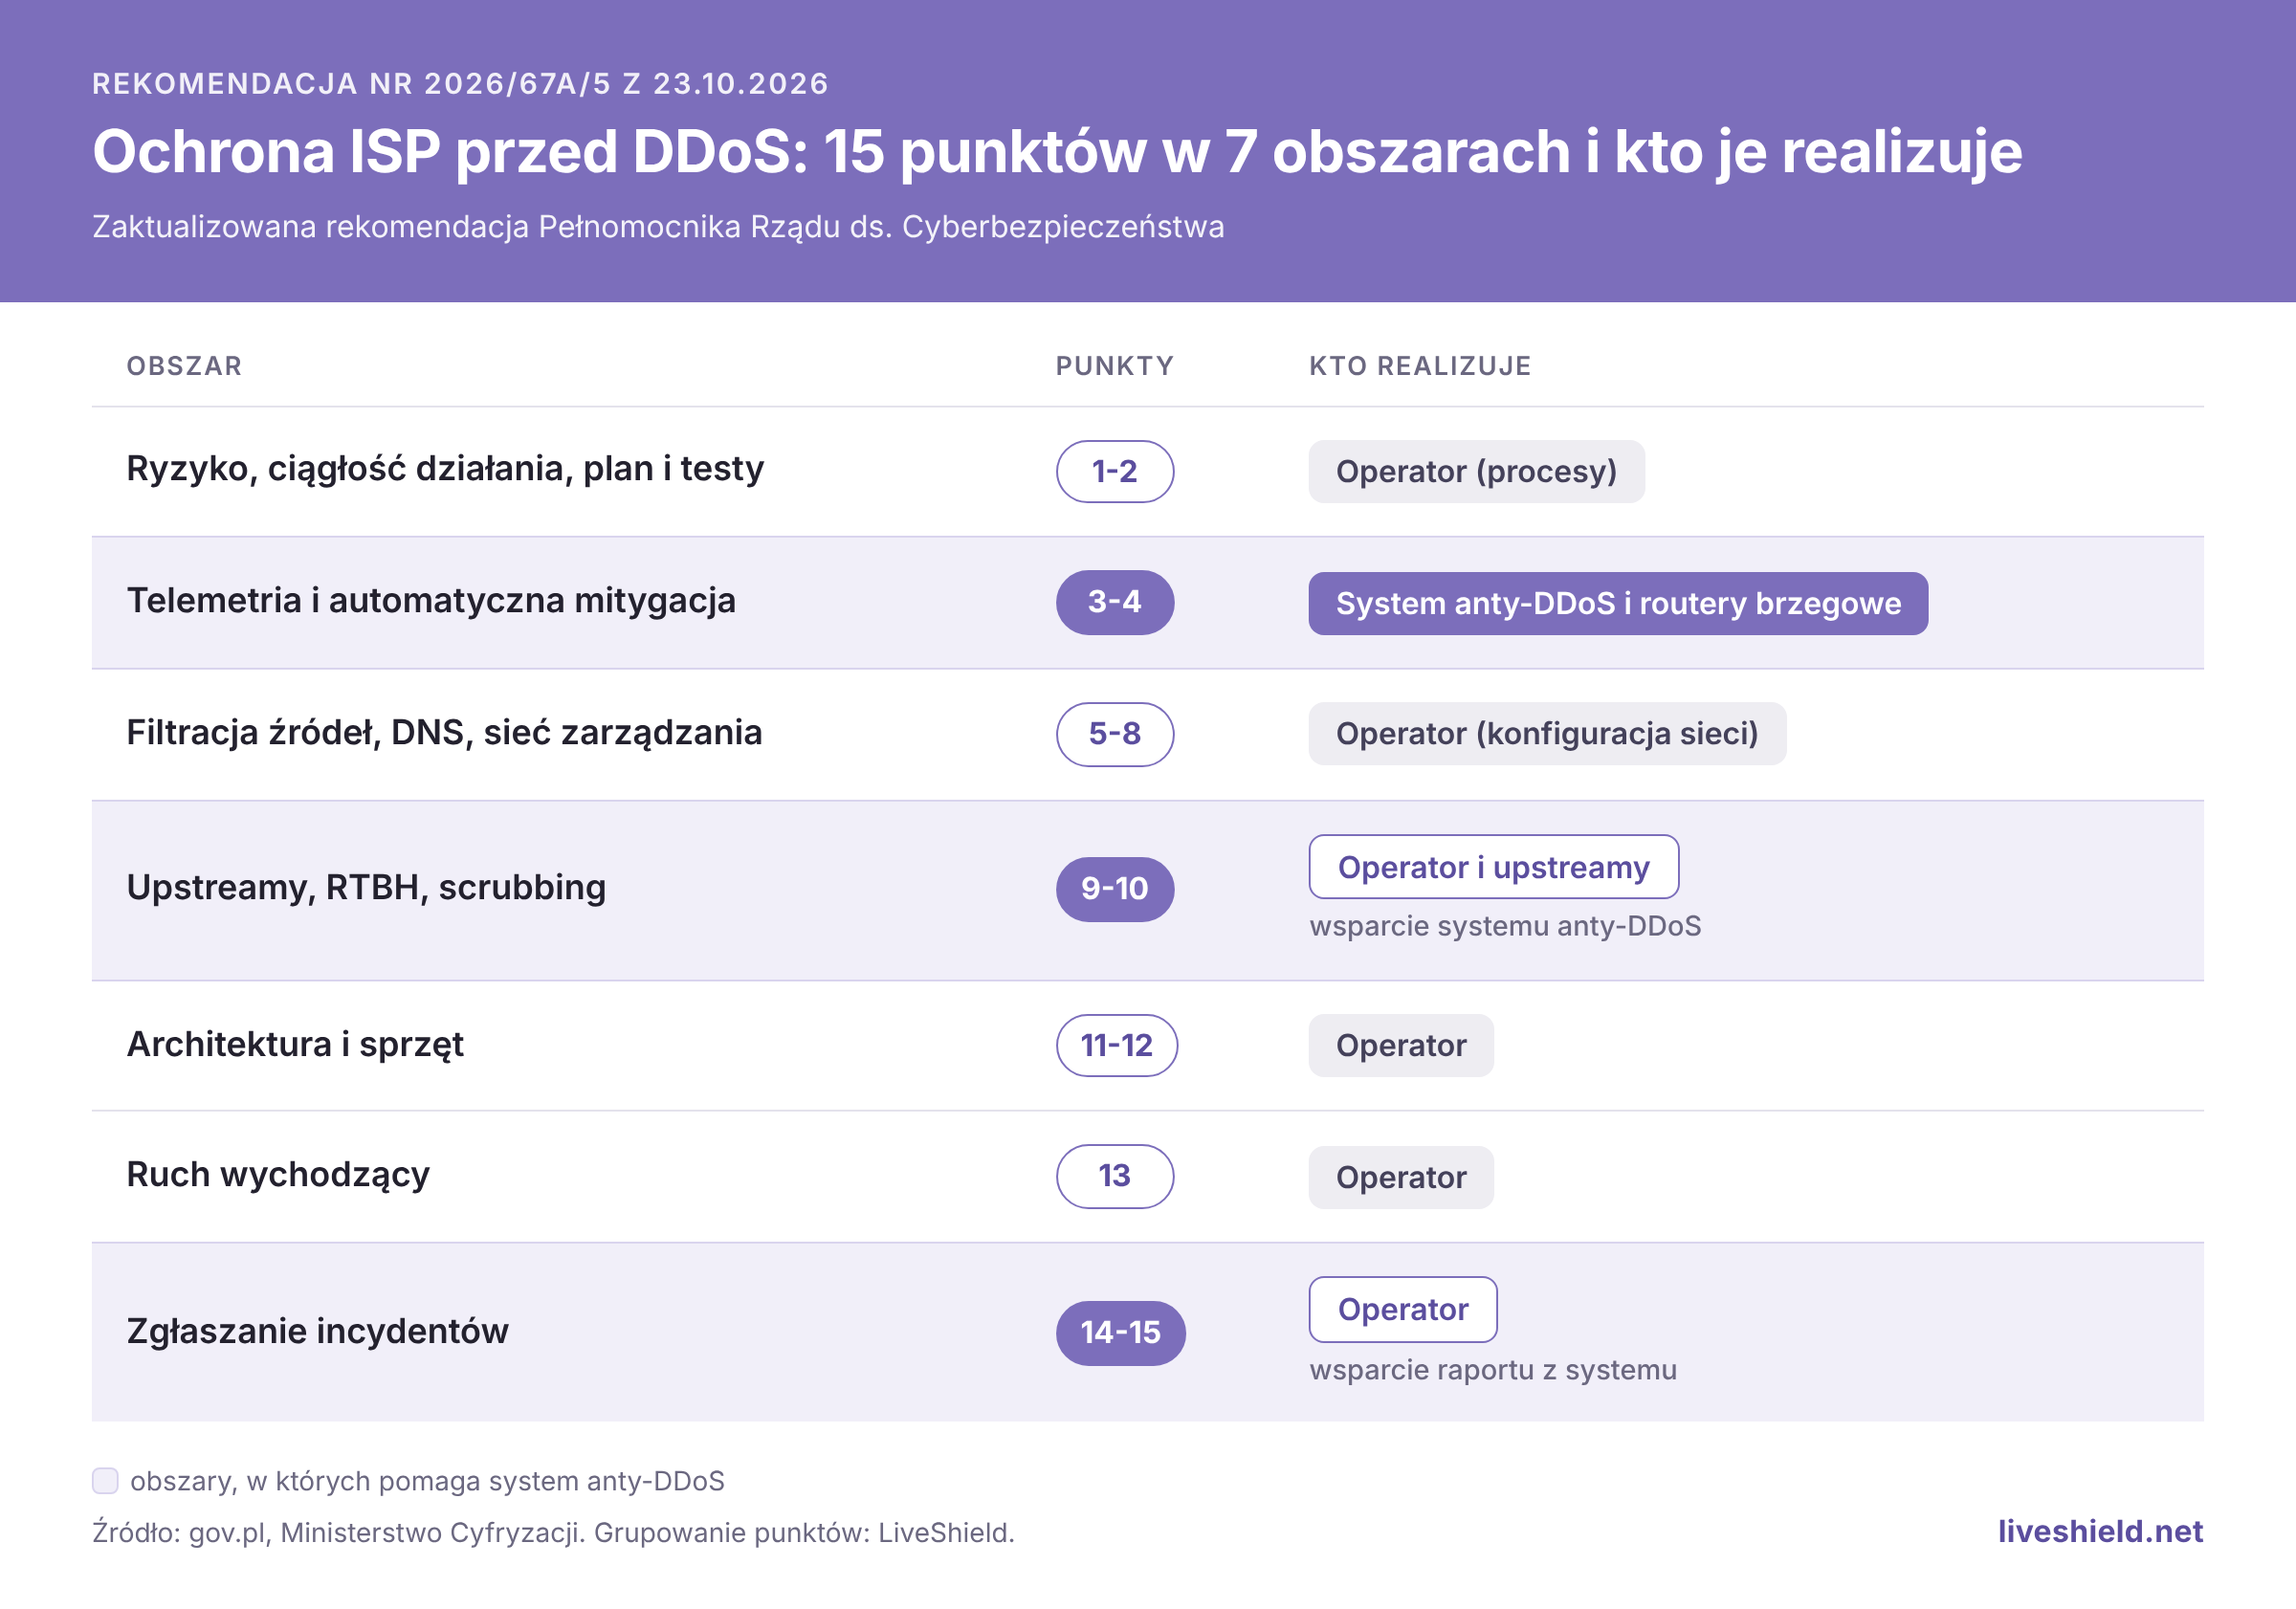
Część punktów dotyczy procesów, część konfiguracji sieci, a część narzędzi do wykrywania i mitygacji. Poniżej porządkujemy je według tego, kto i gdzie je realizuje, oraz wskazujemy, które z nich może wspierać system anty-DDoS taki jak LiveShield.
Czego dotyczy rekomendacja i kto ma ją realizować?
Rekomendacja obejmuje cały cykl obrony: od oceny ryzyka, przez konfigurację sieci i mitygację, po zgłaszanie incydentów. Większość punktów to zadania operatora w jego własnej sieci. System anty-DDoS dotyczy bezpośrednio tylko części z nich.
Co rekomendacja mówi o telemetrii i automatycznej mitygacji?
Zaleca próbkowanie ruchu na routerach brzegowych i automatyczne odrzucanie lub ograniczanie ruchu o charakterystyce ataku. Jako przykład podaje mitygację z wykorzystaniem BGP FlowSpec.
Dane telemetryczne mają pozwalać wykryć DoS i DDoS, więc obejmują adresy źródłowe i docelowe, natężenie w pps, fps i bps oraz flagi TCP. Dla operatorów bez takich możliwości rekomendacja wskazuje stateless filtry firewall i policery na interfejsach WAN.
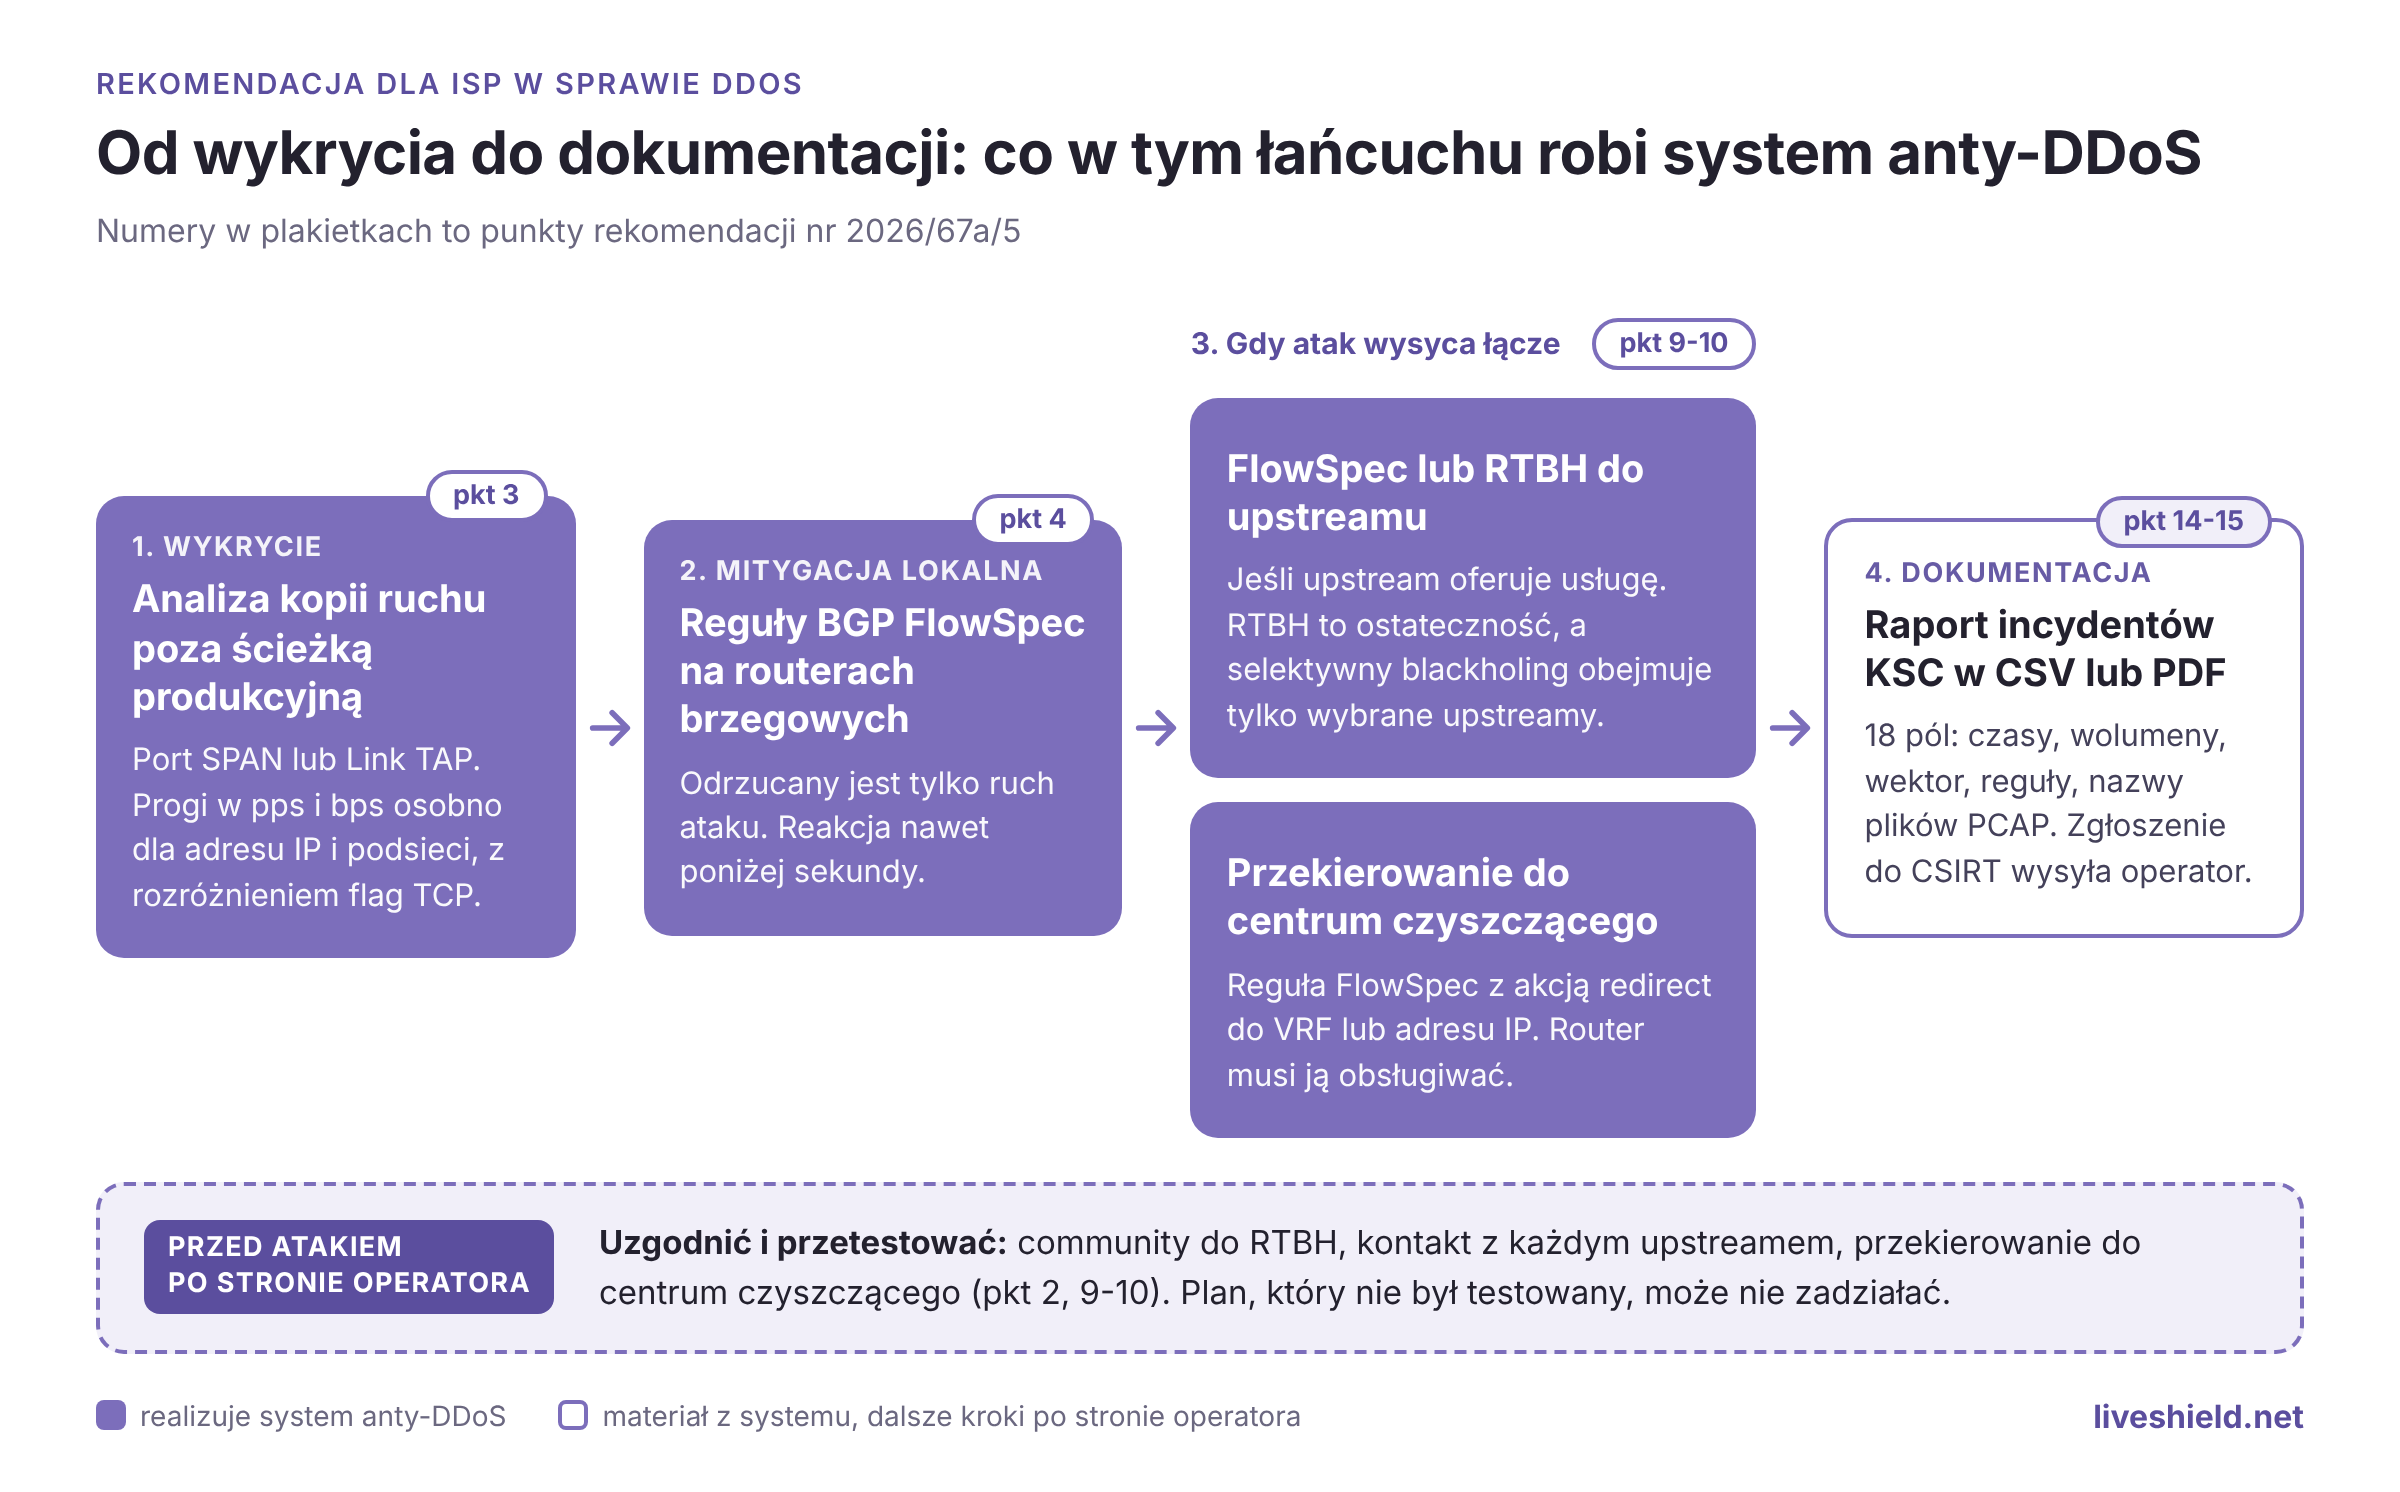
LiveShield realizuje ten obszar inaczej niż próbkowanie: analizuje kopię ruchu z portu SPAN lub Link TAP, poza ścieżką produkcyjną, a nie tylko próbki. Progi w pps i bps ustawia się osobno dla pojedynczego adresu IP i dla podsieci, a dla wybranych protokołów TCP system rozróżnia flagi (m.in. SYN, SYN-ACK, ACK, RST). Po wykryciu ataku reguły BGP FlowSpec trafiają na routery brzegowe, a pierwsza reguła może pojawić się w ciągu sekundy. Zasady detekcji opisuje dokumentacja, a sam proces wpis o wykrywaniu ataku.
Co z upstreamami, RTBH i scrubbingiem?
Rekomendacja wymaga, żeby te mechanizmy były uzgodnione i przetestowane przed atakiem, a nie w jego trakcie. Dotyczy to kontaktu 24/7 z operatorami upstream, mechanizmów RTBH, community do blackholingu oraz umowy z dostawcą scrubbingu.
W praktyce operator powinien mieć odpowiedź na trzy pytania:
Czy każdy upstream oferuje FlowSpec i RTBH oraz jakie community lub parametry są wymagane?
Jak szybko można uruchomić kontakt z upstreamem w trakcie ataku?
Czy przekierowanie ruchu do scrubbing center jest przygotowane technicznie i czy ktoś je kiedykolwiek przetestował?
LiveShield wspiera tę konfigurację na kilku poziomach. Blackholing (RTBH) pozostaje ostatecznością, gdy wcześniejsze kroki nie wystarczają. System ogłasza trasę /32 lub /128 dla atakowanego adresu z lokalnym community, które router przepisuje na community wymagane przez konkretnego dostawcę. Dzięki selektywnemu blackholingowitrasa trafia tylko do upstreamów przeciążonych atakiem, a pozostali dostawcy, peeringi i IXP nadal wymieniają ruch. Dokumentacja zaznacza, że blackholing zwykle działa tylko u dostawców IP transit, a na peeringach prywatnych i punktach wymiany zwykle nie jest wspierany.
Selektywny blackholing w LiveShield oznacza ograniczenie trasy do wybranych upstreamów. Nie należy go mylić z S/RTBH wymienionym w rekomendacji, który jest osobnym mechanizmem i wymaga uRPF na interfejsach filtrujących.
Gdy atak przekracza przepustowość łącza uplink, lokalna ochrona nie wystarczy. Wtedy FlowSpec lub RTBH trafia do upstreamu, jeśli ten oferuje taką usługę, albo ruch jest przekierowywany do zewnętrznego centrum czyszczącego. W LiveShield służy do tego przekierowanie ruchu (traffic diversion): po wykryciu ataku na prefiksie system generuje regułę FlowSpec z akcją redirect do wskazanego VRF lub adresu IP. Router musi obsługiwać akcję redirect. Całość opisujemy w materiale o łączeniu lokalnej ochrony ze scrubbing center. Przygotowanie umowy ze scrubbingiem, ROA w RPKI i LOA, o których mówi rekomendacja, pozostaje po stronie operatora i dostawcy tej usługi.
Jak przetestować plan, żeby rzeczywiście zadziałał w trakcie ataku?
Rekomendacja stwierdza wprost, że plan, który nie był testowany, w praktyce może nie zadziałać. Test powinien objąć ścieżkę techniczną i komunikacyjną: od wysłania trasy blackhole, przez jej odbiór u upstreamu, po kontakt z ludźmi, którzy ją obsługują.
Dla blackholingu można to sprawdzić bez czekania na atak. Manual Rules pozwalają utworzyć ręczny blackholing dla wskazanego prefiksu, z wybranym community i upstreamami, niezależnie od progów automatycznej detekcji. Kolejność działań jest następująca:
Wybrać adres, którego chwilowa niedostępność nie zaszkodzi usługom, bo blackholing odrzuca także ruch legalny.
Utworzyć regułę z community uzgodnionym z dostawcą i zatwierdzić zmiany.
Sprawdzić na routerze, czy trasa pojawiła się z właściwym community. Zapis reguły w Managerze nie potwierdza jeszcze, że router ją zastosował.
Potwierdzić u dostawcy, że otrzymał trasę, akceptuje prefiks /32 i odrzuca ruch do tego adresu. Najprościej zrobić to przez looking glass dostawcy lub zapytać go bezpośrednio.
Wyłączyć lub usunąć regułę. Ręczne reguły nie wygasają same, działają do czasu wyłączenia.
Taki test warto powtarzać po każdej zmianie u upstreamu lub w konfiguracji routerów.
Jak zgłaszać incydenty do CSIRT, także te odparte?
Rekomendacja każe zgłaszać incydenty niezwłocznie przez system S46 lub formularz na cyber.gov.pl. Podkreśla, że należy zgłaszać także ataki odparte oraz te, w których sieć ISP była źródłem. Do czasu ustanowienia sektorowego CSIRT dla komunikacji elektronicznej zgłoszenia trafiają do CSIRT NASK. Możliwy jest też kontakt z UKE.
Zgłoszenie ma zawierać m.in. zakres adresacji, numer AS, czas trwania ataku, wpływ na podmioty publiczne i dane kontaktowe osoby odpowiedzialnej. Rekomendacja zaleca też zachowanie danych z incydentu jako materiału dowodowego.
Tu LiveShield przygotowuje materiał, ale nie wysyła zgłoszeń. Manager generuje raport incydentów KSC z zapisanych rekordów ataków, w formacie CSV lub PDF. Raport zawiera 18 pól, m.in. czas wykrycia, czas pierwszej reguły filtrowania i czas do mitygacji, maksymalny wolumen i PPS, wektor ataku, docelowe adresy, użyte reguły FlowSpec i blackholingu, nazwy plików PCAP oraz statystyki ruchu w ujęciu minutowym. Użytkownik generuje go ręcznie i sam decyduje, co przekazać dalej. Szerzej o tym, jak system może pomóc w zgłoszeniu do CSIRT, piszemy na blogu. Szczegóły pól opisuje dokumentacja raportowania.
Które punkty rekomendacji wymagają działań poza systemem anty-DDoS?
Większość z nich. System anty-DDoS nie zastępuje konfiguracji sieci ani procesów, i dobrze, żeby operator nie oczekiwał tego od żadnego dostawcy.
Poza zakresem systemu pozostają m.in.:
uRPF lub statyczne ACL zgodne z BCP 38 oraz filtracja bogonów na portach dostępowych,
blokowanie na brzegu sieci ruchu protokołów wykorzystywanych do amplifikacji (np. NTP, SNMP, SSDP) i anycast dla własnych usług DNS,
izolacja sieci zarządzania i dostęp out-of-band niezależny od sieci produkcyjnej,
łącze awaryjne od innego dostawcy, co najmniej dwóch niezależnych dostawców tranzytu i niezależne kanały komunikacji,
oferta dual stack dla klientów, z taką samą dbałością o filtrację dla IPv6 jak dla IPv4,
analiza anomalii w ruchu wychodzącym i skanowanie sieci pod kątem otwartych resolverów oraz podobnych usług.
Te elementy zmniejszają powierzchnię ataku i skutki jego pominięcia. System anty-DDoS odpowiada za wykrycie i mitygację w chwili, gdy atak już trwa. Oba obszary się uzupełniają.
Od czego zacząć?
Od przeglądu własnej sieci pod kątem 15 punktów rekomendacji i od rozmowy z każdym upstreamem o FlowSpec, RTBH i community. Pełny tekst rekomendacji jest publicznie dostępny na stronie Ministerstwa Cyfryzacji.
Działanie panelu LiveShield można obejrzeć w publicznym demo na demo.liveshield.net. Dokumentacja techniczna jest dostępna na docs.liveshield.net, a o wdrożenie w swojej sieci można zapytać pod adresem [email protected].